김대정 · Maker
사용자와 현장의 문제를 발견하고, 필요한 기능의 기획·디자인·개발부터 출시·운영까지 주도해 왔습니다. 콘텐츠 생성 서비스와 의료 지식베이스, 병원 운영 시스템을 구축했으며, AI 기능 검증과 데이터 평가·운영 도구 개발을 통해 사용자 반응과 품질 평가 결과를 제품 개선에 반영했습니다.
MediSolve AI · 2025.04 — 재직 중
Tech Lead · Backend Engineer
AI 콘텐츠 제품의 출시·운영, 사내 시스템 개발, 공통 개발 기반과 Azure 인프라 운영 담당
Thready — AI 콘텐츠 서비스 개발·운영
제품 기획·디자인·개발부터 출시·운영까지 주도
마케팅·운영지원 팀과 함께 월 1천만원 수준의 구독 매출 달성 · 2026년 8월 기준
SNS 콘텐츠를 생성·검토하고 예약 발행하는 구독 서비스. 사용자 행동에서 발견한 필요를 기능으로 만들고 실사용 반응으로 다음 개선을 정하며, 사용자 서비스와 운영 백오피스, AI 생성 품질 기준과 검수 도구를 직접 개발
제품·AI 실행과 품질 데이터 흐름
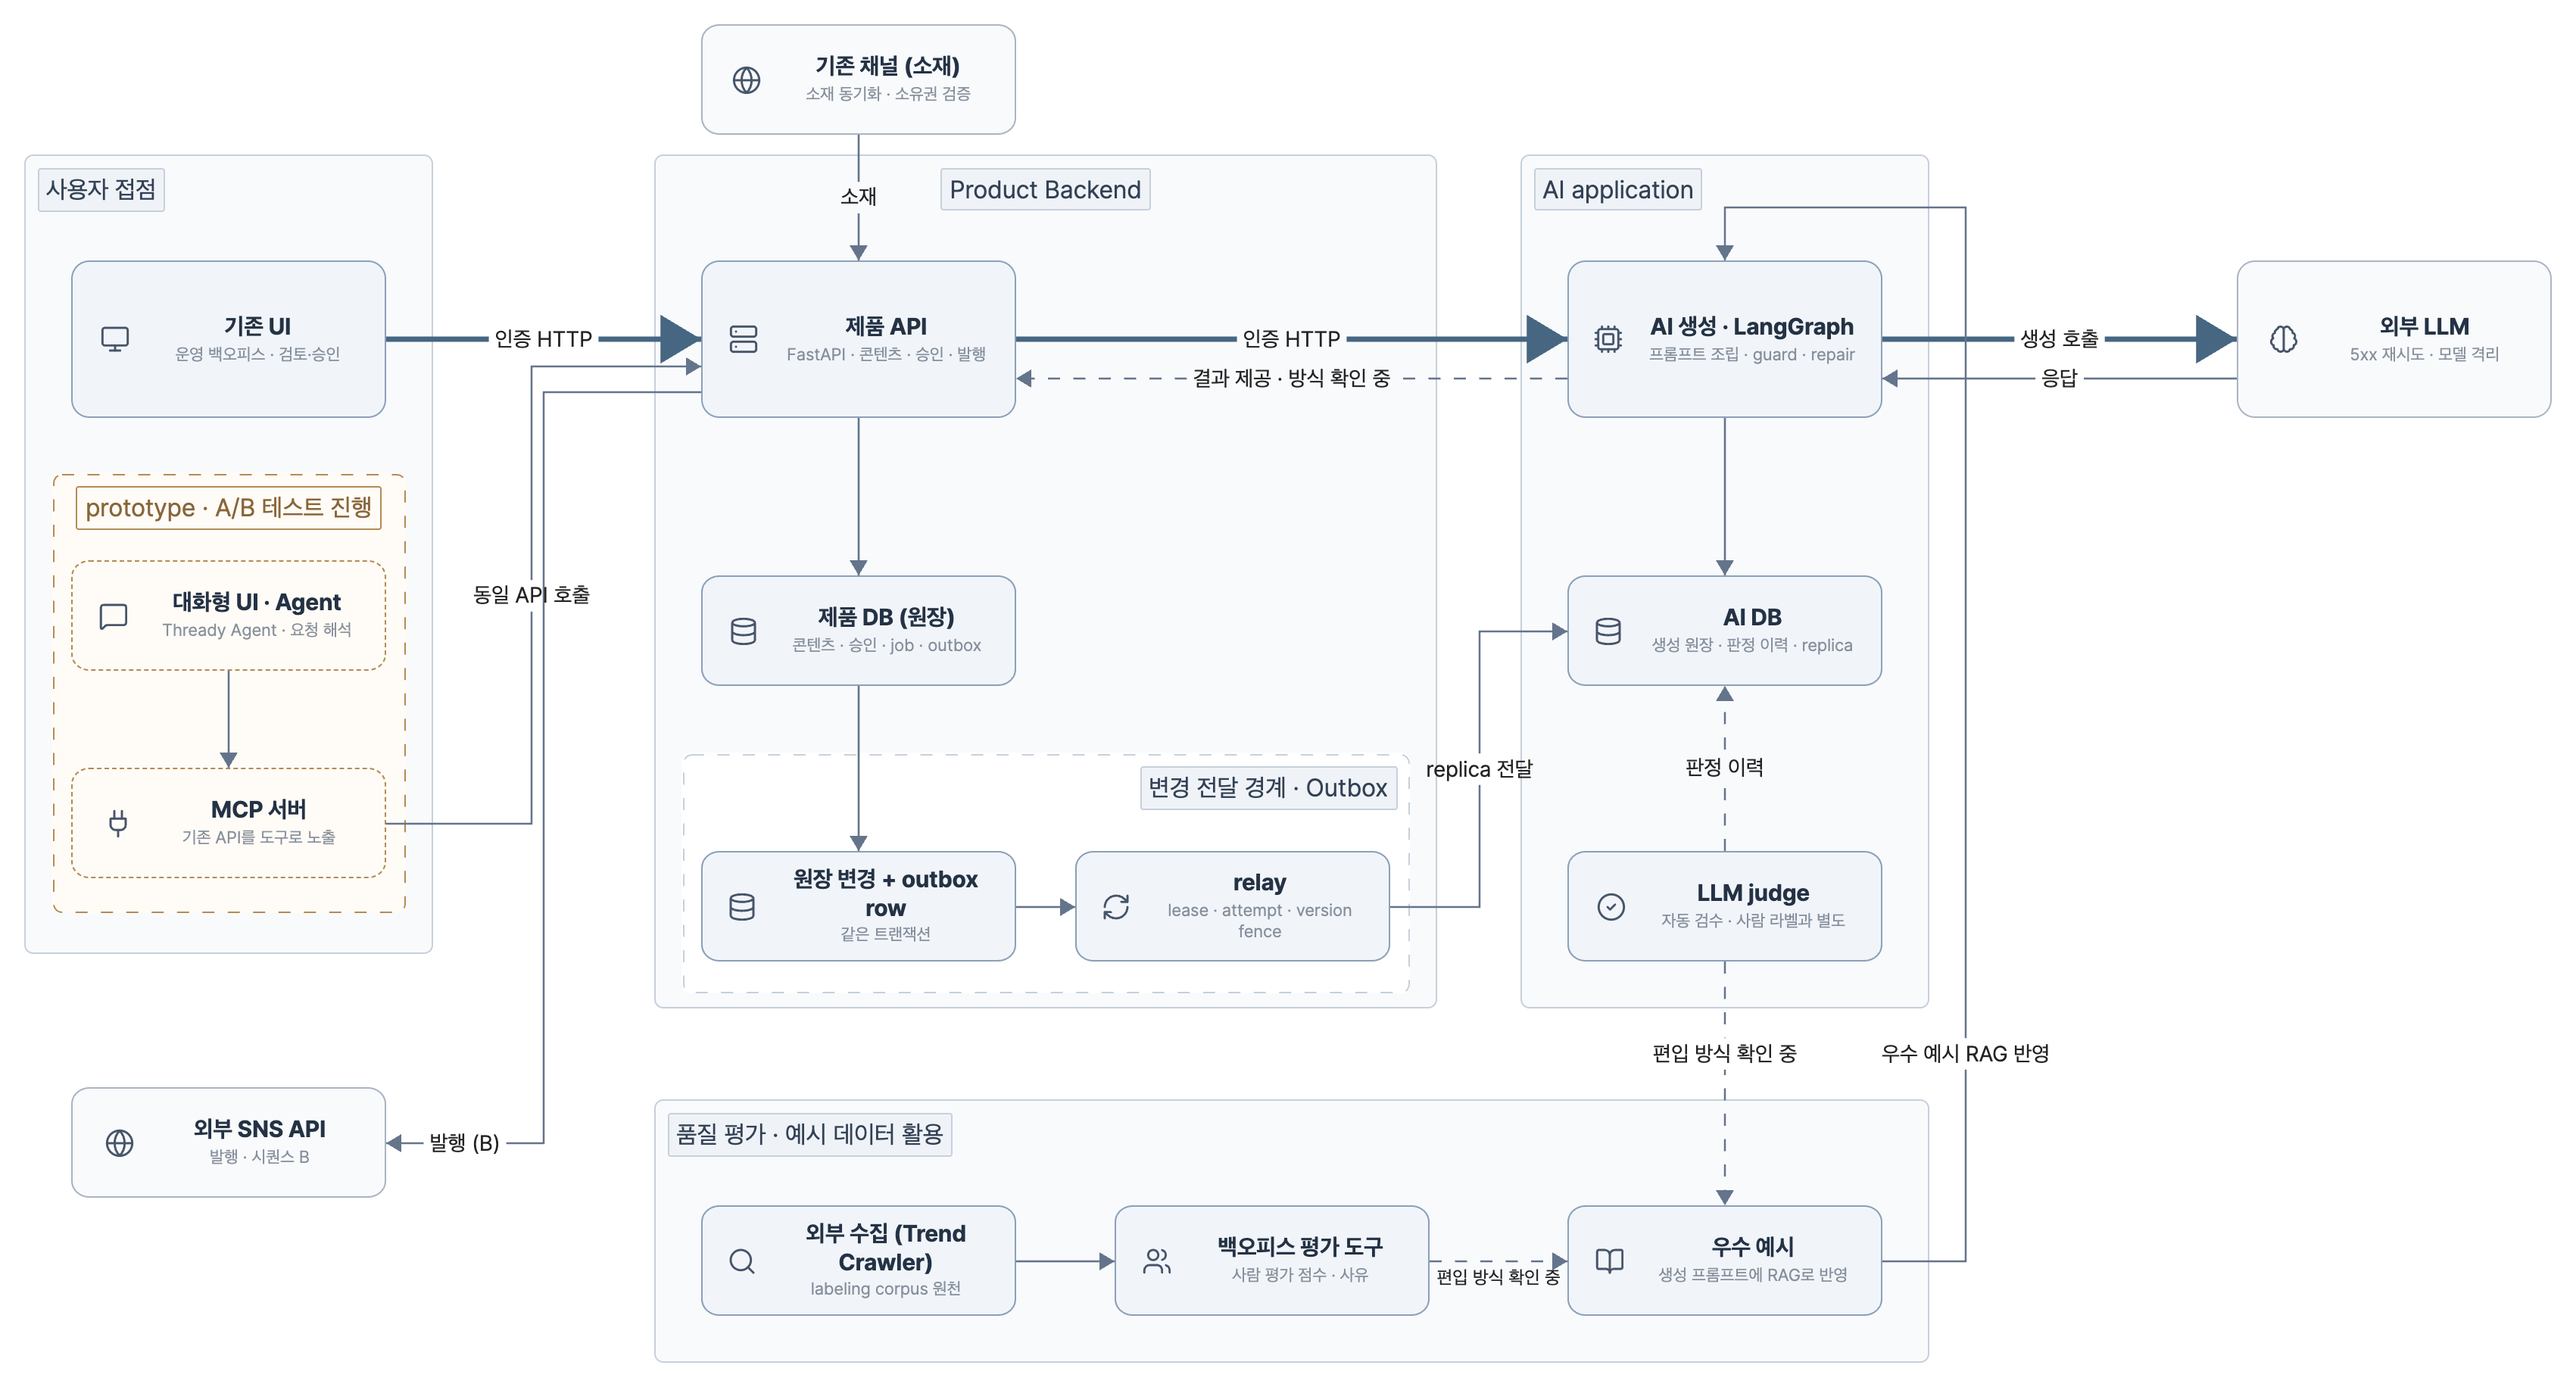
인플루언서는 이미 여러 SNS를 운영하면서 Threads로 채널을 넓히려 했고, 의료진에게는 병원을 알릴 새로운 채널이 필요했습니다. 추가 인력과 시간을 투입하기 어렵고 플랫폼마다 글의 문화가 다르다는 제약을 함께 다뤘습니다.
A. 대화형 Agent 실험으로 수요 검증
SNS를 활발히 쓰는 고객 대상 약 2주 테스트에서 기존 이용 기준 대비 방문 횟수 3.6배, 구독 유지와 상위 요금제 결제 사례로 매출 유지·확대에 기여
선택의 이유
기존 API를 재사용하는 프로토타입으로 대화형 인터페이스 수요를 먼저 검증해, 새 기능 개발에 앞서 사용자 반응을 확인
관찰 → 판단 → 변경 → 관측
| 단계 | 내용 |
|---|---|
| 관찰 | 자연어 지시형 입력 반복, 고객의 대화형 AI 사용 경험 |
| 판단 | 대화형 인터페이스 수요 — 새 기능 대신 기존 기능을 Agent로 연결해 먼저 검증 |
| 변경 | 기존 API를 MCP 서버로 연결한 Thready Agent 프로토타입, 실제 고객 A/B 테스트 |
| 관측 | 하루 한 번 길게 머물던 이용이 반복 방문으로 변화, 방문 횟수 3.6배 · 구독 유지 · 상위 요금제 결제 사례 (약 2주 · 기존 이용 기준 · 테스트 진행 중) |
B. 비동기 생성으로 대기 없는 작업 흐름
여러 글을 미리 확보해 두고 쓰는 사용 패턴에 맞춰 생성 완료 대기와 결과 확인 시점을 분리
- 행동 추적 데이터에서 사용자가 글을 한 건씩 발행하기보다 여러 글을 미리 확보해 두고 쓰는 패턴을 확인. 콘텐츠 생성 요청을 백그라운드 처리로 전환해 생성 중에도 다른 작업을 이어갈 수 있게 지원
- 전환 뒤 완료 결과를 확인하지 않는 후속 문제를 발견. 전체 생성 완료 30분 뒤 미확인 시 카카오톡 1회 알림을 다음 개선안으로 제안
C. 승인 정합성과 발행 실패 복구
승인 데이터의 정합성을 확보하고, 외부 발행 실패 유형에 따라 재처리·복구 경로 설계
선택의 이유
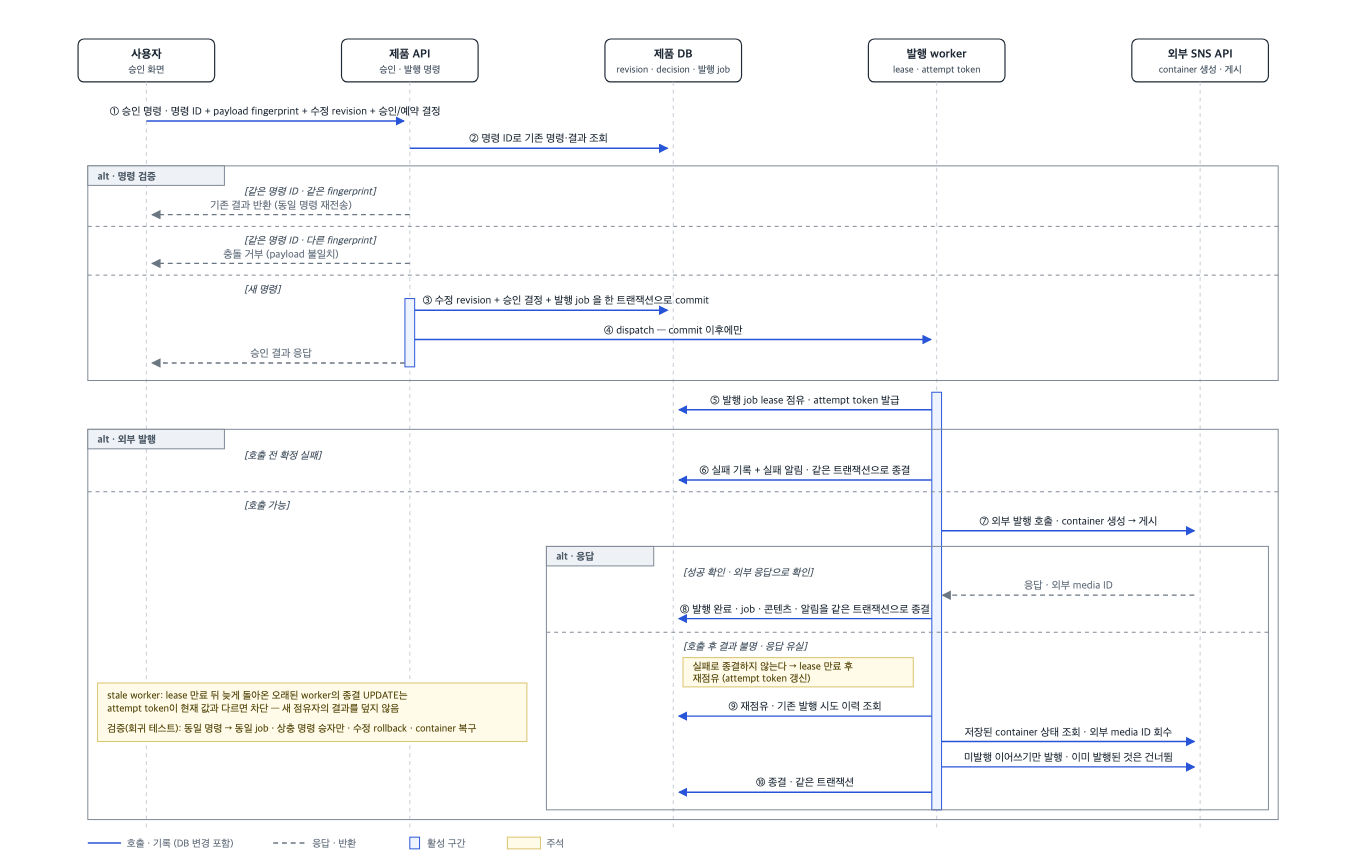
고객의 수정본·승인 결정·예약/발행 작업은 한 번에 확정돼야 하고, 링크 재클릭이나 재전송이 새 결정으로 처리되면 안 됨 — 명령마다 ID와 payload fingerprint를 두어 같은 명령은 기존 결과로, 다른 payload는 충돌로 구분
외부 발행 실패는 호출 전 확정 실패와 호출 뒤 응답 유실로 나뉨. 전자는 실패로 종결하고 후자는 기존 시도 이력으로 이어가, 성공한 발행을 다시 만들지 않고 멈춘 발행만 재개
승인·발행 정합성과 실패 복구
구현
- 수정 버전·승인 결정·발행 작업을 한 트랜잭션으로 확정하고 commit 뒤에 worker로 전달. 승인 링크로 발급한 세션은 갱신돼도 원래 만료 시각을 넘기지 않음
- 발행 작업은 lease와 attempt token으로 점유해 오래된 worker가 결과를 덮어쓰지 못하게 차단. 결과 불명인 시도는 저장된 외부 SNS 발행 container 상태로 게시물 식별자(media ID)를 회수하고, 이미 발행된 이어쓰기는 건너뜀
- 발행 작업·콘텐츠·실패 알림의 종결을 같은 트랜잭션으로 묶어 부분 성공 상태가 남지 않게 처리
검증
- 같은 명령의 동일 작업 반환, 상충 명령의 승자만 반영, 잘못된 수정의 rollback, 호출 후 예외 → lease 만료 → 동일 container 복구를 회귀 테스트로 고정
- 구독 서비스의 승인·발행 기능을 개발하고 출시·운영 담당
D. 생성 품질 평가·개선 체계
자료 정리·초안·1차 검수는 시스템이 반복 처리하고, 최종 수정과 예약·발행 판단은 사람이 내리는 구조로 생성 품질을 운영 이력으로 관리
선택의 이유
생성 기능만으로는 품질을 판단할 수 없어, 결과의 점수뿐 아니라 판단 이유와 개선안을 함께 남겨 다음 검토와 프롬프트 개선에 쓰는 구조를 선택
구현
- 말투 유형(반말·반존대·존대·구어 등)·문장 유형(설명·요약 등)·구조(한 줄형 등)를 매핑한 글 데이터에 사람의 정성적 품질 평가를 1~10점 척도로 기록. 우수 예시를 선별해 RAG로 검색하고 생성 프롬프트에 반영
- 생성 파이프라인을 기획·판단(planner)과 작성(writer) 역할로 분리해 구현. 생성 실험에서 writer에 둔 글 유형 분기 판정이 발동하지 않는 것을 확인하고 판정 책임을 planner로 재배치
- LLM judge의 점수·통과 여부·사유·개선안을 검수 이력으로 저장해 생성·프롬프트 품질의 1차 판단 근거로 사용
- 십만 건 규모의 한국어 글 데이터를 정제해 운영 백오피스 안에 콘텐츠 평가·라벨링 도구 구축. 평가자가 작업을 이어갈 수 있도록 작성자·기간·평가 여부 필터, 진행률·다음 미평가 글 이동, 점수·사유 입력을 갖춘 평가 화면 구현. 재적재에도 기존 평가 보존
역할
제품 기획·화면 설계와 프론트엔드·백엔드 개발을 함께 맡아 콘텐츠 생성·예약·발행·관리 화면의 사용 흐름을 직접 구현. 콘텐츠 품질 검토는 관련 담당자와 협업
E. 생성 평가 데이터와 판단 기준 검증
글을 만드는 과정에서 어떤 역할이 무엇을 판단하는지 분리했습니다. 생성 파이프라인을 기획·작성 역할로 나누고, 콘텐츠 유형 분기를 작성 역할에 뒀을 때 실제로 수행되지 않는 문제를 확인해 기획 역할로 옮겼습니다. 생성·검수·보정 흐름은 LangGraph로 구현했고, LLM 검수의 점수·통과 여부·판단 사유·개선안을 저장해 생성과 프롬프트의 1차 품질 근거로 사용했습니다.
평가는 자동 게이트·실측 분포 대조·사람 판정으로 나눴습니다. 형식 검사를 통과한 결과라도 사람의 콘텐츠 판단은 별도로 남겼습니다. 자체 생성 결과가 다시 프롬프트 기준값의 근거가 되는 순환을 재실측으로 발견하고, 평가 기준과 문제 축을 교정한 경험도 있습니다.
콘텐츠 기준을 확인할 데이터도 직접 구축했습니다. Threads 게시물과 성과 시계열을 수집·정규화·동기화하고 전일·작성자별 비교 보고를 구현했습니다. 2026년 8월 분석 스냅샷의 십만 건 규모 URL별 최신 상태와 수백만 건 규모 시계열 관측을 구분해, 절대 조회수뿐 아니라 작성자·분야 대비 성과를 비교하는 기준을 설계했습니다. 수만 건 규모 도입부 품질 분석은 실험용 생성 프롬프트와 LLM 평가에 연결했습니다.
사람 검수 도구에서는 본문·이어쓰기와 평가를 나눠 관리하고 점수·판단 사유·검수 진행을 기록했습니다. 로컬 전체 데이터 적재와 증분 재적재에서 기존 평가 보존과 건수 정합성을 확인했습니다. 별도의 사후 시험에서는 실제 importer로 십만 건 규모 합성 원문·이어쓰기를 갱신한 뒤 전체 식별자·내용·건수를 기대값과 대조했습니다. 이어쓰기 교체 직후 오류를 넣었을 때 기존 원문이 보존되고 신규 데이터가 rollback되는 것도 확인했습니다.
F. 외부 I/O와 DB 연결 분리
기존 YouTube 소재를 가져오는 기능은 채널 조회와 DB 반영의 경계를 나눴습니다. 외부 응답을 기다리는 동안 DB 연결을 잡아 두지 않고, 조회가 끝난 뒤 저장 트랜잭션을 열어 upsert하도록 구현했습니다. 외부 실패는 채널별로 격리하고, 내부 상태를 보존하며, 성공적으로 사용한 소재를 계정별로 제외했습니다.
| 처리 구간 | 책임과 보호 조건 |
|---|---|
| 외부 채널 조회 | 외부 대기 중 DB 연결 미점유, 실패 채널과 내부 저장 상태 분리 |
| 조회 결과 저장 | DB 트랜잭션 안에서 실제 upsert 수행 |
| 취소·오류 | 해당 동기화의 원장 미변경과 연결 정리 확인 |
| 다음 콘텐츠 생성 | 성공 소비 이력을 확인하고 소재가 고갈되면 중단 |
2026년 9월 사후 기술 검증에서는 실제 동기화 서비스와 격리 PostgreSQL DB를 사용했습니다. 비교 대상은 외부 대기를 트랜잭션에 넣은 새 비교용 구현이며 과거 제품 코드가 아닙니다. 제한된 연결 풀과 mock 외부 지연을 동일하게 둔 짧은 로컬 합성 시험에서 현재 구조가 비교군 대비 약 2배의 완료 처리량을 보였습니다. 외부 대기 중에도 독립 DB 조회가 진행되는지, 종료 후 연결이 반환되는지, 최종 저장 내용이 기대값과 같은지를 함께 확인했습니다.
외부 I/O를 저장 경계 밖에 둔 선택이 제한된 연결 풀의 경합에 미치는 영향을 확인한 사후 비교입니다.
G. AI 실행 분리와 Outbox 전달 검증
생성 실행은 별도 AI 애플리케이션·DB로 분리하고 STG·production에서 운영했습니다. 제품 정책과 원장은 백엔드가, 생성 lifecycle과 실행 상태는 AI 애플리케이션이 소유합니다. 원장 변경과 Outbox 기록을 같은 트랜잭션에 넣고, 외부 전달은 이후 worker가 수행합니다. lease와 attempt token은 재점유한 작업의 소유권을, 전달 버전은 오래된 응답과 역순 전달을 통제합니다.
| 실패 상황 | 구현한 처리 |
|---|---|
| 승인 결정 경합 | 대기 상태의 조건부 갱신으로 하나의 결정만 반영 |
| 전달 worker 중단 | 만료된 lease를 기준으로 재점유 |
| 새 변경 이후 이전 ACK·실패 응답 도착 | 버전·시도 식별자로 오래된 결과의 반영 통제 |
| 전달 재시도 소진 | 실패 행을 보존해 운영자가 상태 확인 |
| 외부 발행 호출 전 실패 | 발행 시도 전 상태와 실패 원인을 구분 |
| 외부 발행 호출 후 결과 불명 | 저장된 발행 시도에서 재개하고 이미 발행된 이어쓰기는 건너뜀 |
사후 격리 시험에서는 실제 승인 repository·Outbox service·Relay facade를 실행했습니다. 승인 경합의 단일 결정, 오래된 ACK·실패 응답 무효화, 외부 실패 후 최신 원장 재전달, 재시도 소진 상태 보존을 확인했습니다. 실패한 전달 작업 뒤에도 정상 작업이 진행되는지 함께 검증했습니다.
외부 AI client를 기록용 mock으로 대체한 시험으로, 검증 범위는 승인과 AI 복제본 전달의 서비스 계약입니다. 외부 발행은 별도의 복구 경계에서 다루며 작업·콘텐츠·실패 알림의 최종 상태를 함께 저장합니다.
P Hub — 사내 의료 지식베이스 구축·운영
상담 서비스의 용어 오해석 문제를 공통 지식 제품으로 전환하고 기획·디자인·개발 주도
상담 현장에서 반복되던 용어 오해석을 공통 지식으로 풀기 위해 만든 사내 지식베이스. 시술 용어와 의사 검증을 거친 의료 자료를 실시간 상담·채팅 서비스에 제공하며 운영 중
A. 공통 용어 기반 상담 응답 보정
상담 서비스가 활용하는 공통 의료 지식베이스를 구축·운영해 상담 응답 보정에 활용, 동일 인터뷰 기준 상담사 만족도 점수 약 15.6% 개선(3.2→3.7점, 5점 만점)에 기여
선택의 이유
상담 실장 피드백에서 STT·번역 결과가 피부과 핵심 용어를 다른 의미로 해석하는 사례를 확인. 같은 문제가 다른 고객 응대 서비스에서도 반복될 것으로 판단해, 한 서비스 안의 보정 대신 서비스들이 함께 쓸 공통 용어 기반을 제안·구축
AI 번역의 비용 대비 효용을 검토해 전문 번역 데이터 조회 방식으로 전환
구현과 역할
- 병원 운영 글로벌 팀의 용어 데이터를 DB에 정리해 STT·번역 응답 보정에 활용
- 사용 지점의 상담사를 초급·중급·고급으로 구분해 동일 인터뷰로 만족도를 평가
- 지식 관리 화면과 조회 기능을 개발해 메디컬 전문팀의 데이터 관리 업무 지원
- 제품 기획·디자인·개발은 직접 주도하고, 용어 정리는 병원 운영 글로벌 팀, 번역은 전문 번역팀, 의학 자료 검증은 의사와 협업
B. 검수된 지식의 검색·제공 경계
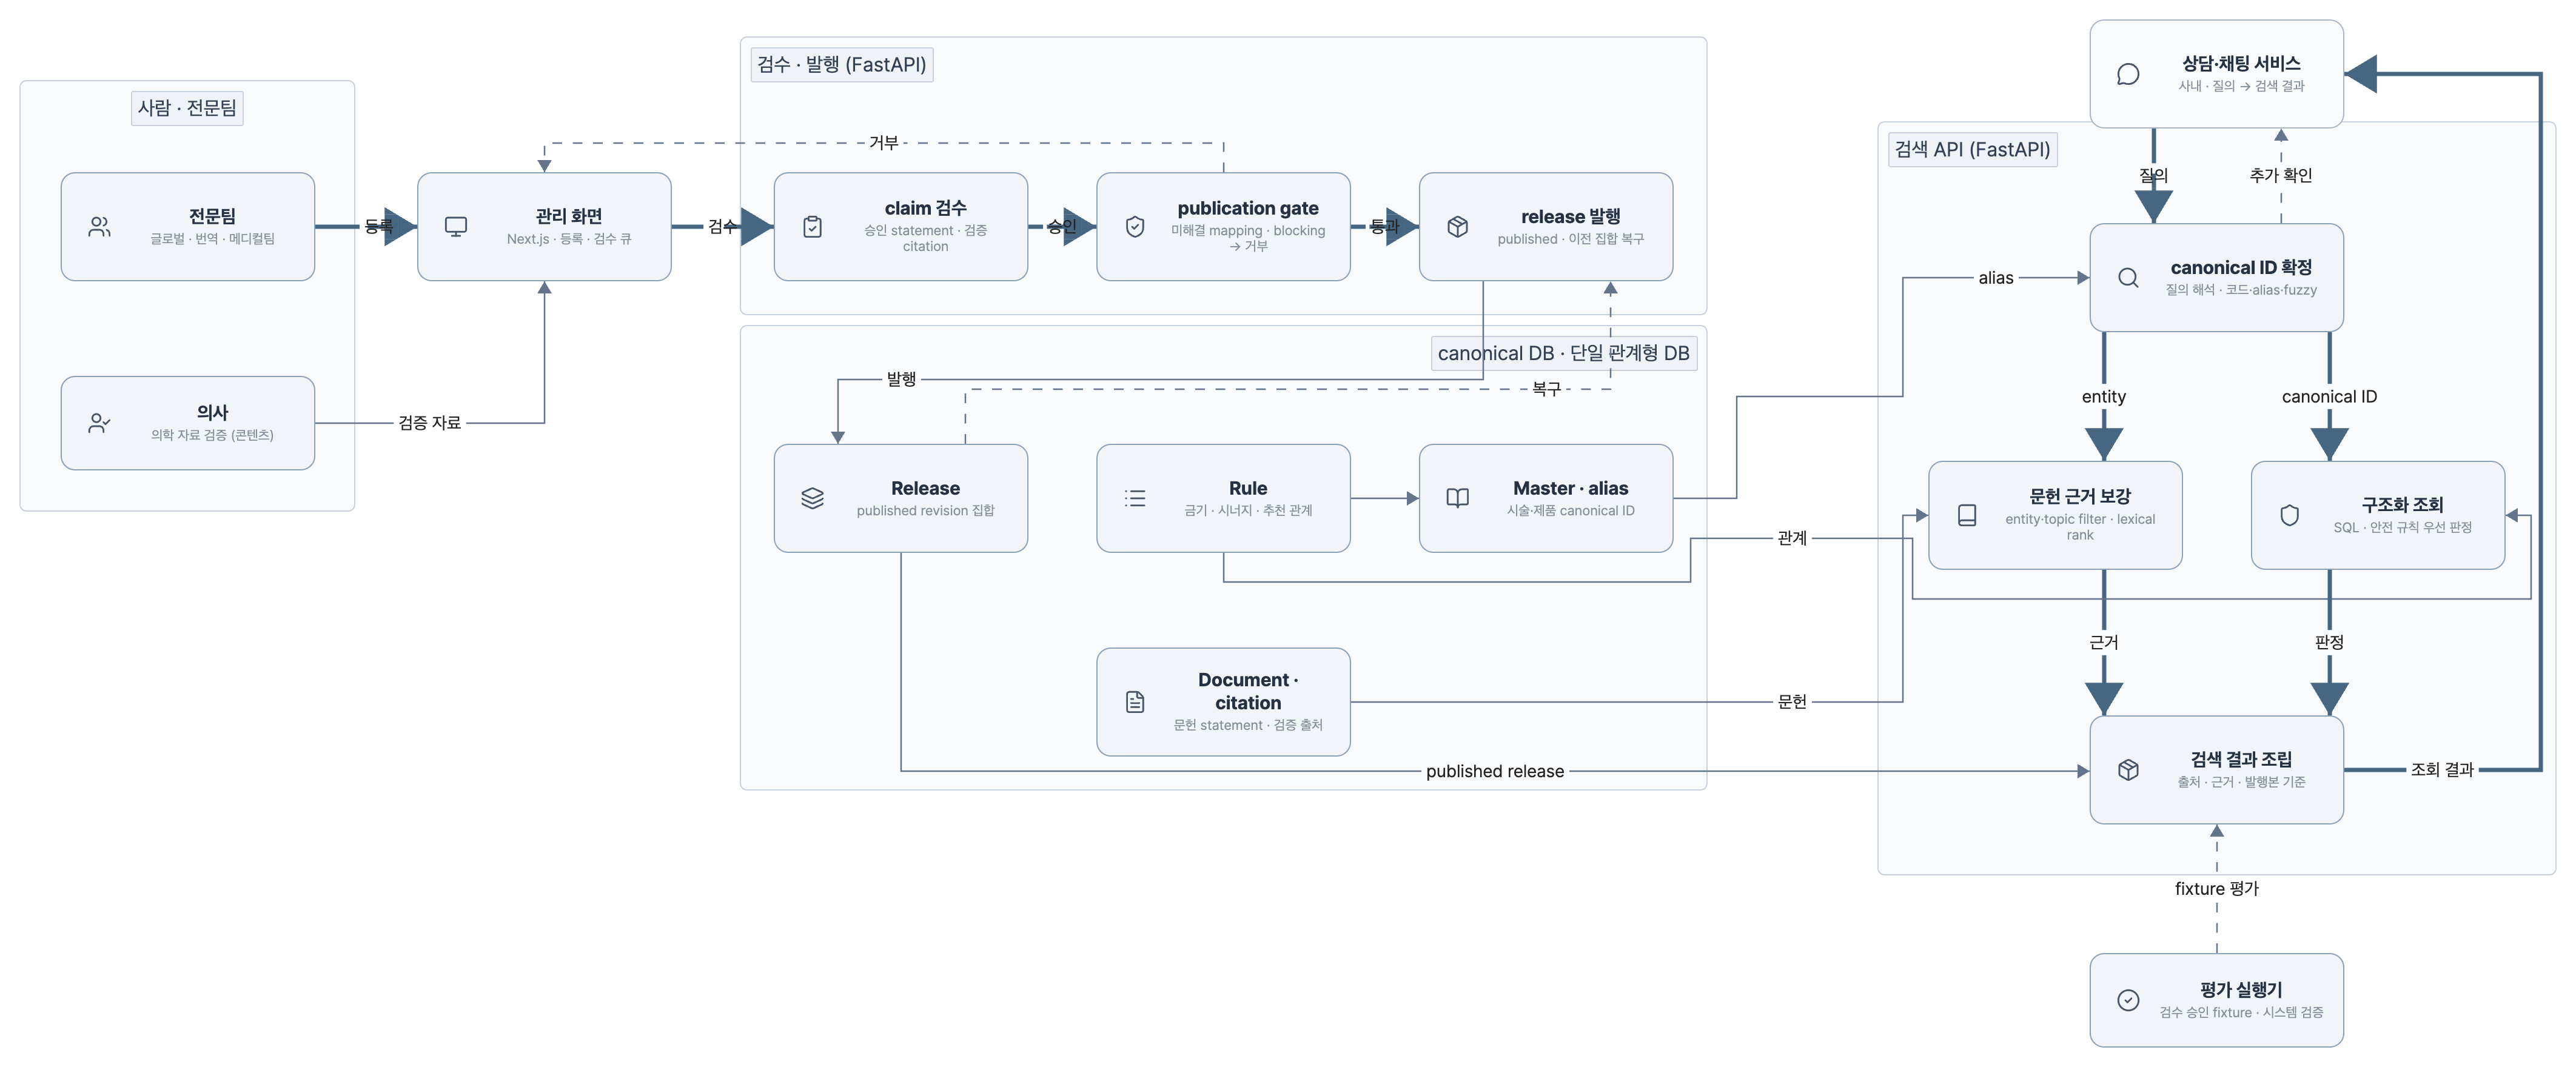
전문팀이 자료를 등록·검수하고 검증된 자료만 상담 서비스에 제공하도록 지식 관리·검색 기능 구축
관계형 지식 조회·문헌 검색 기반 검색 API와 검수·발행 기능을 구현
선택의 이유
시술·제품·금기·추천처럼 관계가 명확한 구조화 데이터가 대부분이라, 문서 전체를 벡터화해 가까운 문장을 돌려주는 방식으로 시작하지 않음
같은 항목을 먼저 확정한 뒤 관계형 데이터 조회를 기준으로 답하고 문헌 검색은 근거를 보강하도록 역할을 분리
지식 등록·검수·발행과 검색 제공 구조
구현
- 시술명·별칭·표기 차이를 같은 항목으로 식별하고, 관계형 조회와 문헌 검색을 결합한 검색 API 구현. 응답에는 출처 근거를 포함
- 검색 관련도와 안전 판정을 분리해, 등록된 안전 규칙이 없다는 사실을 병용 가능으로 읽지 않고 모호한 항목은 추가 확인이 필요한 상태로 반환
- 기존 JSON 지식을 관계형 데이터로 옮기며 기존 API 동작을 테스트로 고정. 검수 승인과 근거 검증을 거친 발행본만 제공하고 문제가 있으면 이전 발행본으로 복구하도록 발행 관리 구현. 데이터 전환·임상 fixture 검수·운영 공개 완료는 별도 확인 필요
- 검수 승인 없는 시험 데이터를 거부하고, 항목 식별·발행 전이·검수 승인·감사 기록과 검색 품질(기대 항목·근거·안전 판정·응답 시간)을 검사하는 평가 실행기 구현
C. 캐시 도입 판단을 위한 사전 검증
반복 조회 비용을 줄이기 위한 캐시 도입 효과를 합성 실험으로 먼저 검증
구현과 범위
- 반복 조회 경로에 캐시를 둘지 판단하기 위해 LLM 에이전트가 수행한 합성 실험 결과를 검토 근거로 활용. 캐시 적중 시 DB 조회 7회→1회 감소 확인
- 실험 결과는 도입 판단의 근거로만 쓰고, 회사 서비스 적용과 운영 효과 확인은 진행 전
사내 인프라 — Azure 구축·운영과 비용 개선
전담자 없이 서비스별로 분산 운영되던 인프라의 구조와 관리 체계를 정비해 보안·배포·모니터링 기반을 구축·운영하고, 자원 통합을 제안·추진해 월 서버 비용 약 30~40% 절감에 기여
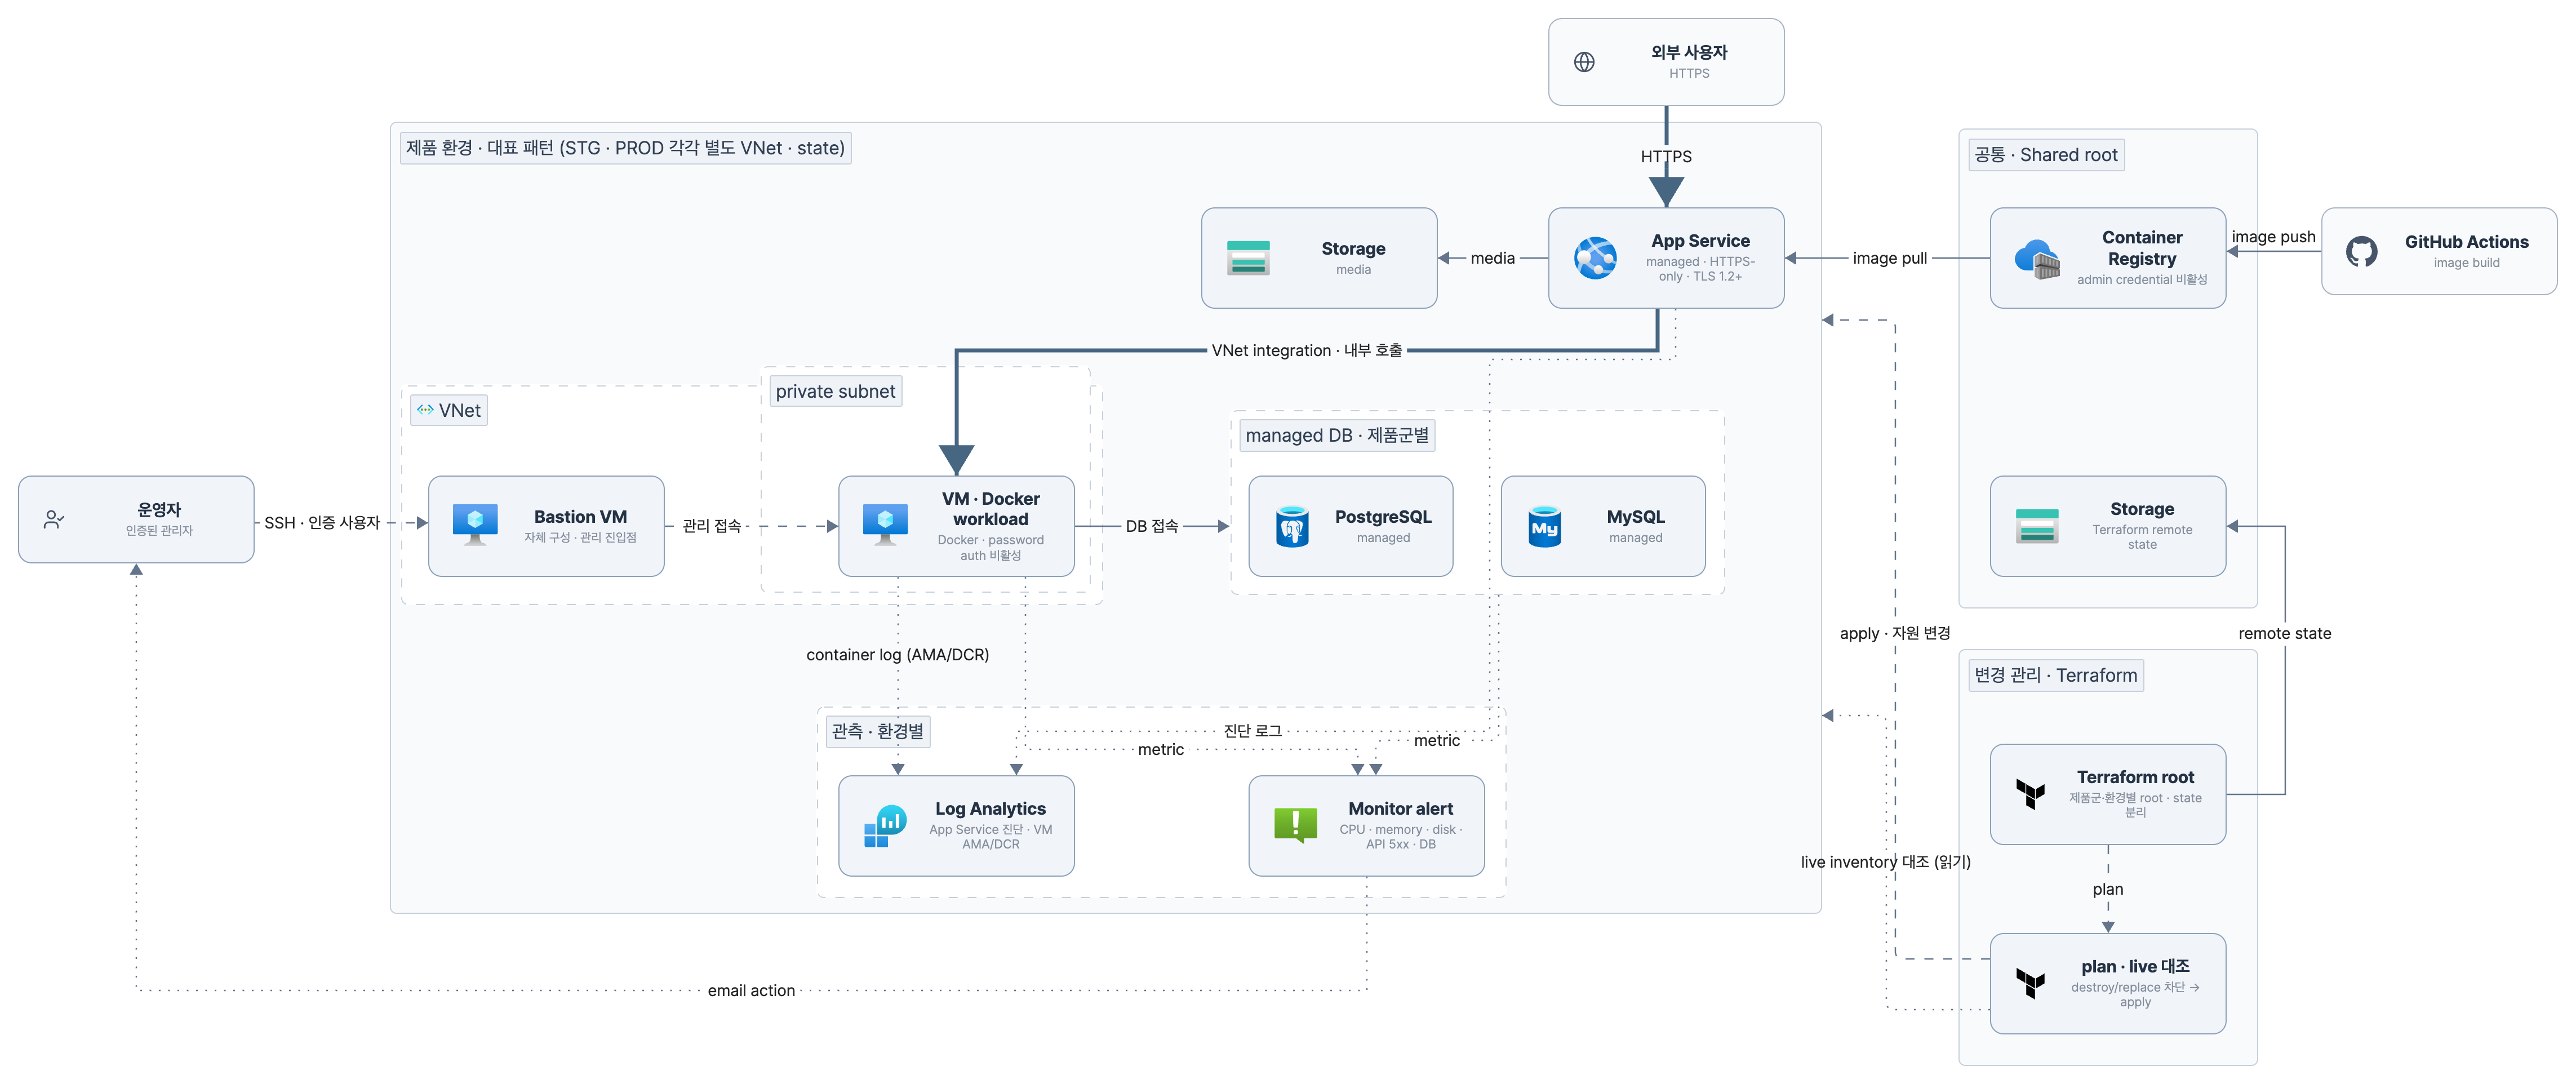
- 서버를 Private 네트워크에 배치하고 관리 접근은 Bastion 인증 경로로만 연결
- 제품군·환경별로 Terraform 구성과 remote state를 분리. plan·state·실제 자원을 교차 확인한 뒤 apply해 의도하지 않은 삭제와 환경 간 변경 전파를 차단
- 공통 Container Registry와 GitHub Actions로 빌드·배포하고, 환경별 VNet의 Docker workload와 managed DB로 실행 경계를 나눔
- 환경별 Log Analytics와 Azure Monitor alert(CPU·memory·disk·API 5xx·DB 가용성)를 Terraform으로 구성·운영
배치와 경계 · 관리 접근 · 배포 · 관측
서비스별로 독립 구축돼 관리가 분산되던 인스턴스의 비효율을 확인하고 자원 통합을 제안·추진. 월 서버 비용을 약 400만원에서 250~280만원으로 낮춰 약 30~40% 절감에 기여
STUDIO LAB · 2021.12 — 2024.01
AI Engineer → Product Manager 중심 → Backend Engineer
SellerCanvas — AI 상세페이지·에디터 제품 기획
하루 이상 걸리던 상세페이지 제작의 자동화를 위해 패션 데이터·배치 기준을 설계하고, AI 엔지니어와 제품 구현으로 연결
생성 요청부터 완성 상세페이지 반환까지 10분 이내(외부 안내 30분)인 제품의 기획·데이터 설계에 기여
A. 제품 요구·제작 흐름 구체화
판단과 기획
- 회사(대표)의 사업 구상·경쟁 제품 분석·고객 인터뷰를 기획 입력으로 제품 요구와 우선순위 정리
- 사용자 인터뷰를 바탕으로 AI 상세페이지·에디터의 사용 흐름 기획
B. 데이터·배치 기준 설계로 자동화 실현
판단과 설계
- 제품 과제는 하루 이상 걸리던 상세페이지 제작의 자동화. 패션 전공자와 상품 데이터의 분류 기준·라벨링을 정리한 뒤 상세페이지 배치 알고리즘을 설계해 특허 「페이지 출력 방법」 공동 발명으로 연결
- AI 엔지니어가 설계 방식을 CNN 기반 모델로 구현했고, 배치 알고리즘은 fallback으로 활용
C. 기업 PoC·제품화
구현 조율과 결과
- 기업 PoC의 요구사항을 기능·기술 검증 항목으로 구체화하고 일정·검증 범위 조율
- 참여 제품의 CES 2024 Best of Innovation AI 부문 수상
PM으로서 제품 기획과 검증 범위 조율을 맡아 프로토타입을 실제 제품으로 구체화
기타 프로젝트 및 개발 경험
사내 AX·개발 생산성
문제
여러 초기 제품의 모니터링에서 DB 연결·세션 관리 오류가 반복적으로 확인됨
판단·구현
세션·트랜잭션 관리를 표준화한 공통 백엔드 템플릿을 구축·배포. 기존 서비스에 개선 사항을 반영하고 신규 서비스의 개발 기준으로 적용
운영 변화
템플릿 적용 이후 동일 유형의 오류 재발이 관찰되지 않음. 백엔드 경험이 적은 담당자도 템플릿을 기준으로 기능을 구현하고 배포 지원을 받는 수준으로 개입 범위가 줄어듦
Mediness(사내 업무·제품 개발 관리 시스템)의 요구사항·검증 흐름 설계와 회사 AX 구조 설계에 참여. 요구사항을 테스트 기준으로 구체화하고, 공통 템플릿과 검증 하네스로 동료의 구현·검증을 지원
트랜잭션 소유권과 취소 처리
한 트랜잭션은 하나의 asyncio task와 AsyncSession이 소유하도록 했습니다. ContextVar로 전파된 세션에 child task가 접근하면 owner-task guard가 즉시 차단합니다. 병렬 DB 작업을 수행하려면 task별 트랜잭션과 연결 비용, 데이터 가시성·실패 복구를 먼저 결정하도록 규칙과 문서를 남겼습니다.
| 정책 | 의미 |
|---|---|
| REQUIRED | 기존 트랜잭션에 참여 |
| REQUIRES_NEW | 새로운 연결·세션으로 독립 트랜잭션 실행 |
| NESTED | 기존 트랜잭션 안에서 SAVEPOINT 사용 |
| child task의 동일 세션 접근 | 소유권 검사로 차단 |
| 작업 취소·예외 | rollback과 세션·연결 정리 |
정상 결과만으로는 이 경계를 확인할 수 없어 취소·예외·전파·잘못된 공유를 통합 시험에 포함했습니다. 2026년 9월에는 Thready에 적용된 실제 DB 모듈을 격리 PostgreSQL DB에서 다시 검증했습니다. 정상·예외·취소가 섞인 수백 회 규모 병렬 실행의 데이터 상태와 종료 후 연결 반환을 확인했습니다.
구현 지원과 릴리스 판단
신규 사내 프로그램은 전체 템플릿으로 시작하고 기존 제품은 DB 세션 관리부터 점진적으로 적용했습니다. 설계 결정·컨벤션·실행 문서를 coding agent가 읽는 공통 맥락으로 구성했고 기획·QA·디자인 담당자가 기능을 구현했습니다. 저는 템플릿과 기준을 만들고 구현 결과에 피드백하며 배포를 지원했습니다.
제품 운영에서는 결정·명세·구현·QA·릴리스가 같은 변경을 가리키도록 연결했습니다. 실제 완료 시점에 릴리스 승인·버전·노트 생성을 묶고, QA 팀원의 지원을 받아 요구별 근거로 PASS·FAIL·UNKNOWN을 판정하는 규칙을 설계했습니다. AI가 결과물을 생성했다는 사실과 요구를 충족했다는 판정을 구분하고, 설계·검증 기준·릴리스 판단의 책임은 사람이 갖도록 했습니다. 회사 업무 AX로 확장하는 구조 설계에는 참여했으며 제품 운영 리드와 설계 참여의 범위를 구분했습니다.
실시간 서비스·인증
SAY — 실시간 전사 세션
실시간 상담에서 WebSocket 재연결과 늦게 도착하는 전사 보정이 경합해, 보정이 다른 발화를 덮어쓰거나 종료된 세션이 다시 연결되는 문제를 분석
중간·확정·보정 전사에 같은 발화 식별자를 부여해 보정이 해당 발화만 교체하도록 구현. 세션 종료·재연결의 정리 책임을 보강하고 회귀 테스트로 고정
양방향 번역에서는 상담사와 고객의 언어에 맞춰 모드를 선택하고 원문·번역문·통역 음성을 연결하는 화면과 이벤트 흐름을 직접 설계·구현했습니다. 상담 전체의 전사·세션 처리는 다른 담당자와 함께 주도했습니다.
| 입력·상태 | 처리 |
|---|---|
| 중간 전사 | 도메인 키워드 조기 판단 |
| 확정 전사 | 문맥 판단·저장 |
| 늦은 보정 | 같은 발화 식별자의 내용만 갱신 |
| 세션 종료 | timer·task·GC·shutdown 정리와 재연결 차단 |
음성 인식 후보는 오류율·키워드 보존·지연으로 비교하는 도구를 만들었습니다. 발화 종료 감지 설정을 바꿔도 모델 추론이 주 병목인 것을 확인해, 중간 전사를 활용한 조기 판단과 외부 모델 연동 분리에 집중했습니다. 상담 E2E의 이벤트·발화 sequence를 대조했고 종료 후 재연결 문제는 정리 경계와 회귀 시나리오로 고정했습니다.
상담 후 평가는 실시간 응답 경로와 분리했습니다. 근거 기반 응답의 품질 평가와 자유 생성 응답의 키워드 추출을 나눠 관리 조회에 연결했습니다. 평가 작업을 선점하는 트랜잭션 뒤에 외부 LLM 분석을 수행하고, 분석이 실패해도 템플릿으로 검토 사례를 남기는 기능을 구현했습니다.
SSO — 공유 인증 세션
여러 제품이 공유하는 인증에서 중복 로그인·계정 전환·그룹 로그아웃 범위를 구분해야 했고, 오래된 로그아웃 요청이 갱신된 세션을 지울 수 있었음
사용자·서비스·기기별 로그인 정책과 Redis 공유 세션을 재설계해 구현. 로그아웃 요청의 토큰 소유권을 확인해 교체된 유효 세션을 보호하고, 정책 분기는 단위 시나리오 테스트로 검증
운영 변화
팀원용 계정·접근 관리 백오피스를 기획·디자인·개발해 운영에 적용. 두 시스템 모두 1차 개발 뒤 운영에서 계속 사용 중
비동기 처리·실패 복구
Centurion BAY — 발주·알림
재고·발주 백엔드를 주도해 안전재고·발주량·대기·진행 주문을 기준으로 발주 대상 판정과 승인 처리를 구현. 공급사·병원 알림처럼 실패할 수 있는 외부 발송은 API 요청과 분리된 worker에서 처리하도록 처음부터 설계
발송 결과에 따른 주문 상태 분기와 실패 기록·수동 재발송 경로를 구현. 당시 Celery의 공식 worker 실행 모델이 asyncio task를 지원하지 않아, FastAPI의 async 코드와 실행 방식을 맞출 수 있는 TaskIQ·RabbitMQ로 전환. 실패한 알림은 운영자가 이력에서 확인하고 다시 보낼 수 있음
발송 결과에 따른 주문 상태 분기·실패 기록·수동 재발송 경로를 구현했습니다. 운영자가 실패를 확인하고 재발송할 수 있는 상태를 남겼으며, worker 실행 성공과 공급사의 실제 수신을 같은 결과로 취급하지 않았습니다. API 테스트 기반·Docker CI·로컬 실행 문서를 함께 구성해 변경을 검증하는 절차를 갖췄습니다.
다른 기능에서도 업무 완료와 외부 연동 결과를 구분했습니다. 시설·시술 현황 조회와 긴급 호출 알림 생성을 구현하고, 시술 완료 시 필요한 품목을 재고 차감 요청으로 전달했습니다. 이 연동의 실패는 시술 완료와 분리해 기록했습니다.
Memento AI — 예약·결제
예약 처리가 실패해도 이미 진행된 선결제와 이용권·마일리지가 남는 조건에서, 결제 상태별 취소·환불 보상 처리를 구현. 환불 요청과 완료를 구분하고, 완료 시점에 마일리지 복원·이용권 삭제를 처리
Memento에서 결제 실패를 직접 수습한 경험이 BAY에서 실패 가능한 작업을 처음부터 worker로 분리하는 판단의 배경
NEXUS — 피부과 CRM·홈페이지 개발·운영
- 병원 운영팀과 직접 소통하며 요구사항을 구체화하고, 디자이너와 기능·화면 흐름·우선순위 공동 기획
- CRM·예약·홈페이지 백엔드와 Azure 인프라 구축, 개발·출시 및 프로젝트 리딩
- 실제 병원 업무에 적용한 시스템을 유지보수하고, 운영 정책 변경과 현업 요청에 대응
데이터 기반 AI 제품 개발
Kidsly — 안면 인식 자동 출결
학생 스타트업 창업에 참여해 팀의 유일한 엔지니어로 안면 인식 자동 출결 시스템 개발 담당. 국가 사업으로 확보한 학습 데이터로 YOLO 기반 안면 인식 모델을 학습해 정확도 99.8% 달성
학생 창업유망팀 300 모의 크라우드펀딩에서 모집액 2.8억원 기록
Deep Scan — 의류 검출
의류 분류 기준을 정리하고 국가 데이터 사업으로 확보한 데이터로 YOLO 의류 검출 모델 개발에 참여. 제품은 한국건설생활환경시험연구원(KCL) AI 정확도 부문 인증 통과